
Pilot çalıştı. Bunun bir benzerini muhtemelen siz de gördünüz: kaydı hâlâ açabilirsiniz, yapay zeka (AI/SI) ajanı (agent) talebi okuyor, siparişi çekiyor, cevabı yazıyor ve neredeyse her seferinde doğru yapıyor. Aradan altı ay geçti, iş hâlâ elle yapılıyor ve odadaki hiç kimse projenin hangi ara tavsadığını, ne zaman rafa kalktığını söyleyemiyor.
Yapay zeka agent pilotu nedir, üretim ne demektir?
Yapay zeka agent pilotu, bir agent'ın gerçek bir iş sürecini seçilmiş bir vaka kümesi üzerinde, insan gözetimi altında yürüttüğü ve işi yapıp yapamayacağını ortaya çıkarmak için kurulan sınırlı bir denemedir.
Üretim ise aynı agent'ın aynı işi tam hacimde, kimsenin ayıklamadığı vakalar üzerinde, işi bitirme yetkisiyle ve attığı her adımın izlenen bir kaydıyla yapmasıdır.
Kısa cevap. Yapay zeka agent pilotları genellikle üç nedenden birine takılıyor: süreç, herhangi bir sistemin takip edebileceği kadar net yazılmamıştır; agent'ın işi bitirmesine hiç izin verilmemiştir; ya da insan gözden geçirme adımı gerçek hacimde devasa bir kuyruğa dönüşmüştür. Hangisinin geçerli olduğunu doğru teşhis etmek, alelacele araç değiştirmekten çok daha önemlidir.
Üretimin dört koşulu var ve dördü birden sağlanmadan pilot üretim sayılmaz:
- Gerçek hacim. İş, gerçekte geldiği hızda geliyor, yoğun dönemler dahil.
- Ayıklanmamış vakalar. Zor ve pürüzlü olanları kimse agent görmeden önce aradan çekip ayırmıyor.
- Bitirme yetkisi. Agent, tanımlı bir aksiyon kümesini son adımı bir insana devretmek zorunda kalmadan tamamlıyor.
- İzlenen kayıt. Attığı her adım, bir insanın baktığı yerde kayıtlı; pratikte bu, işi dağıtan ve ne olduğunu raporlayan bir gözetim katmanı demek.
Tuzak şu: bir yapay zeka agent pilotu birinci koşulu karşılayıp diğer üçünü karşılamayabilir ve yine de başarılı diye kayıtlara geçebilir. Gerçek hacimde çalıştı, ama her vakayı yine bir insan açtı ve raporlanan rakam tamamlanmış bir sonuç değil, soyut bir verimlilik tahminiydi. Baktığımız ve yarı yolda kalan projelerin ezici çoğunluğu tam olarak bu kalıba giriyor.
Bu yazı agent'ın ne olduğunu baştan tanımlamıyor. Çalışan bir demo gördüğünüzü ve şu anki asıl meselenin bir sonraki aşamaya bütçe ayırıp ayırmamak olduğunu varsayıyor.
Yapay zeka agent pilotları neden başarısız oluyor?
Yapay zeka agent pilotları üç nedenden başarısız oluyor ve dışarıdan bakıldığında üçü de aynı görünüyor: proje sessizliğe gömülüyor. Ancak üçünün de ilacı farklıdır ve bu çözümler birbirinin yerine geçmez. Asıl marifet, hangi çıkmazın içinde olduğunuzu açıkça adlandırmaktır.
Üçünün ortak tablosu şu: kimse projeyi resmen iptal etmez. Bütçe bir sonraki çeyreğe ötelenir, toplantılar seyrekleşir ve bir noktada iş yine sessiz sedasız elle yapılır hale gelir. On kişilik bir ekipte bunun meali, bir kişinin altı ay boyunca mesaisini gömdüğü emeğin buharlaşıp gitmesidir.
| Arıza modu | Genelde nasıl anlatılır | Onu tanıtan belirti | Gerçekte neyi çözer |
|---|---|---|---|
| Tanımsız süreç | "Agent tutarsızdı" | İki kıdemli çalışan aynı süreci birbirinden farklı anlatıyor | Süreci yazın: girdiler, karar kuralları, durma kuralları |
| Son mil açmazı (esirgenen yetki) | "Çalıştı ama tasarruf yoktu" | Agent'ın uçtan uca bitirdiği tek bir vaka dahi gösterilemiyor | Tanımlı bir alt kümede bitirme yetkisi, geri alınamayan aksiyonlarda onay kapısı |
| Gözden geçirme kuyruğu | "Ölçeklendikçe yavaşladı" | Kalite iyi görünürken çevrim süresi çakılıyor, bekleyen işler yığılıyor | Her kalemi değil örneklem gözden geçirin, risk derecesine göre kademelendirin, kuyruğu ölçün |
Bunu yanlış teşhis etmenin faturası, aynı duvara toslayan ikinci bir yapay zeka agent pilotudur. Tanım sorunu yaşayan bir ekip platform değiştirir ve dört ay sonra yeni agent'ın da tam olarak aynı kararda bocaladığını görür; çünkü o karar aslında ikisi için de hiçbir zaman yazılmamıştı. Araç değişikliği sadece araç sorunlarını çözer. Yazılmamış bir süreci, son adımda esirgenen yetkiyi veya tıkanan bir kuyruğu çözemez.
Birinci arıza modu: süreç hiç tanımlanmamıştı
Bu, tanımsız süreçtir. Yapay zeka agent pilotu, sürecin tek bir kıdemli çalışanın kafasındaki sürümüyle yürütülmeye çalışıldı ve o sürüm hiçbir zaman kâğıda dökülmedi. Yalnızca bir zihinde duruyor, kimsenin hesaba katmadığı istisnaları var ve son bir yılda iki kez sessizce değişti.
Belirti. İki kıdemli çalışan aynı süreci farklı anlatıyor ve ikisi de kendi açısından haklı. Ya da yazılı bir doküman var, ama işin düğümlendiği asıl kritik karar noktasında "duruma göre değerlendirilir" yazıyor ve kimse bu ifadeyi somut bir kurala dönüştüremiyor.
Somut bir örnek: iade sürecinde "müşteri düzenli müşteriyse esnek davranırız" yazıyor. Düzenli müşteri kaç siparişten sonra düzenli sayılıyor, esneklik hangi tutara kadar geçerli ve nihai kararı kim veriyor? Bu üç soru netleştirilmeden hiçbir agent o adımı tutarlı yürütemez. İşi bugün yapan insan ise bu üç boşluğu da yılların getirdiği tecrübeyle kendiliğinden dolduruyor ve bunu kimseye söyleme gereği duymuyor.
Bir agent bu boşluğu yeni işe alınan bir insandan çok daha hızlı gün yüzüne çıkarır; sorunun agent'tan kaynaklandığının sanılmasının sebebi de budur. Yeni başlayan personel boşluğu eski işinden edindiği sağduyuyla doldurur ve kimseye ses etmez. Agent ise ya durup sorar ya da tahmin yürütür; her iki durum da log kayıtlarına kabak gibi yansır. Oysa boşluk zaten oradaydı; yapay zeka agent pilotu sadece onu önünüze seren ilk ayna oldu.
Çözüm herhangi bir araç kararından önce gelir. İşin ihtiyaç duyduğu girdileri, her karar noktasındaki kuralları ve işin durup bir insana devredileceği sınırları net olarak yazın. Ağdalı bir politika belgesi hazırlamanıza gerek yok. İşi fiilen yapan kişinin kaleme aldığı ve işi yapan ikinci bir kişinin onayladığı tek bir sayfa yeterlidir.
Bu, "daha iyi dokümantasyon yapalım" çağrısı değildir. Bu, süreçteki en ucuz teşhis yöntemidir: bir öğleden sonra, tek bir sayfa; çıkacak ilk fikir ayrılığı bile aradığınız asıl bulgudur.
İkinci arıza modu: agent'ın işi bitirmesine hiç izin verilmedi
Bu, son adımda yetkinin esirgenmesi yani son mil açmazıdır. Yapay zeka agent pilotu yalnızca taslak ya da öneri üretmekle sınırlandırıldı. Vakayı hâlâ bir insan açıyor, bağlamı hâlâ o okuyor, taslağı hâlâ o denetliyor ve nihai aksiyonu yine bizzat o alıyor. Agent işin sadece ortasını yazıyor, iki ucu yine insanda kalıyor.
Gelin hesabı basitçe kâğıda dökelim. Uçtan uca dokuz dakika süren bir vaka düşünün: bağlamı bulup okumak üç dakika, cevabı hazırlamak dört dakika, kapanış adımlarını atmak (kaydı güncellemek, sisteme işlemek, göndermek) iki dakika. Taslak modunda insan hem baştaki üç dakikayı hem sondaki iki dakikayı harcamaya devam ediyor; üstüne bir de taslağı okuyup kontrol etmek için yaklaşık bir buçuk dakika mesai harcıyor. Dokuz dakikaya karşılık 6,5 dakika harcanıyor; yani sağlanan tasarruf sadece 2,5 dakika. Dokuz dakikanın dörtte birinden biraz fazla, üstelik yalnızca taslak hatasız çıktıysa. Oysa agent'ın tek başına bitirmesine izin verilen alt kümede tasarruf, o vakalarda dokuz dakikanın tamamıdır.
Belirti. Pilot raporundaki tasarruf kalem başına ufak tefektir; kimse agent'ın ilk talepten kapanışa kadar tek başına sırtlayıp bitirdiği tek bir vaka dahi gösteremez.
Çözüm her alanda kontrolsüz özerklik vermek değildir. Tanımlı bir vaka alt kümesinde tam bitirme yetkisi vermek, geri dönüşü olmayan riskli aksiyonların önüne ise onay kapısı koymaktır. Pratikte bu, alt kümeyi pilot başlamadan önce belirlemek ve yetkileri ona göre tanımlamak demektir; tıpkı herhangi bir personele rolüne göre sınırlandırılmış yetki verdiğiniz gibi, ya hep ya hiç demek yerine kontrollü alan açmaktır.
Taslak modunun altıncı aya kadar uzamasının nedeni genelde teknik engeller değildir. Kimse yetki sınırını genişletmeye cesaret edemez, kapsamı belirleyen yazılı bir metin yoktur ve mevcut ara form kimsenin canını yakmadığı için öylece sürer gider. Bu yüzden çözüm yeni bir model denemek değil, yetkili bir yöneticinin imzaladığı net bir görev listesidir.
Taslak modu ilk hafta için makul bir başlangıçtır. Ancak altıncı ayda hâlâ taslak modunda kalmak bir zaaftır.
Üçüncü arıza modu: gözden geçirme adımı kuyruğa dönüştü
Bu, gözden geçirme kuyruğu tıkanıklığıdır. Agent'ın ürettiği her bir kalem mutlaka bir insanın onayına düşer ve tek bir kalemi incelemek hızlı sürdüğü için kimse bunun toplam maliyetini hesaba katmaz. Kalem başına iki dakika; günde on talepte yirmi dakika eder, göze batmaz. Ancak günde 240 talepte 480 dakika eder, yani sekiz saat: bir çalışanın başka hiçbir şeye elini sürmediği tam bir mesai günü. Günde 400 talepte ise 13 saatin üzerine çıkar ve bunu tek bir denetçinin karşılaması imkânsızdır.
İşin asıl can alıcı boyutu şudur: Kalem başına iki dakikayla çalışan bir denetçinin azami kapasitesi saatte 30 kalemdir. Saatte 24 kalem geldiğinde (yani kapasitenin %80'i), kuyruk makul kalır ve yapay zeka agent pilotu kağıt üzerinde harika görünür. Ancak akış saatte 28 kaleme çıktığında (%93 doluluk), denetçi teoride işten hâlâ hızlı olmasına rağmen kalem başına bekleme süresi katlanarak fırlar; çünkü işler hiçbir zaman cetvelle ölçülmüş gibi eşit aralıklarla gelmez.
Bu durumun arkasındaki matematiksel prensibin bir adı ve köklü bir geçmişi vardır. John D. C. Little, kuyrukta bekleyen ortalama kalem sayısı, kalemlerin geliş hızı ve her birinin sistemde geçirdiği ortalama süre arasındaki bağı A Proof for the Queuing Formula: L = λW başlıklı çalışmasında kanıtladı (Operations Research, cilt 9, sayı 3, sayfa 383-387, 1961).
Belirti. Kalite metrikleri kağıt üzerinde iyi görünür, fakat çevrim süresi tepetaklak olur, masada bekleyen işler dağ gibi birikir ve gözden geçirenler mesai bitimine doğru talepleri panikle toptan onaylamaya başlar.
Çözüm. Her kalemi tek tek incelemek yerine örneklem usulüyle denetleyin. Gözden geçirme sürecini, hatalı bir kalemin şirkete verebileceği olası zarara göre kademelendirin: telafisi pahalı ve kritik vakalar tam denetimde kalsın, düşük riskli rutin işler ise rastgele örneklemeyle kontrol edilsin. Sadece model doğruluğuna değil, kuyruk uzunluğuna odaklanın.
Bu tablo sadece yüzlerce kişilik çağrı merkezlerinin sorunu değildir. On kişilik bir ekipten bahsediyorsak denetim yükü genelde tek bir kişinin, çoğu zaman da takım liderinin omzuna biner ve o kişinin mesaisi zaten gırtlağına kadar doludur. Kuyruk o yöneticinin masasında birikir; kimse kuyruk dinamiğini ölçmediği için de kabahat haksız yere "agent çok yavaş çalışıyor" diye kayda geçer.
Çok kritik bir noktayı özellikle belirtmek gerekir: Göz boyamak için yapılan göstermelik denetim, hiç denetim yapmamaktan bile daha tehlikelidir; çünkü aslında gerçekleşmemiş bir kontrolün sahte güvencesini ve yanıltıcı kaydını üretir.
Yayımlanmış bir yapay zeka başarısızlık oranı gerçek mi, nasıl anlarsınız?
Yapay zeka agent projelerine özel, doğrulanabilir birincil kaynağı ve metodolojisi kamuya açık olarak yayımlanmış genel geçer bir başarısızlık oranı yoktur. Piyasada dolaşan afaki yüzdeler ya çok genel geçer yazılım projelerini aynı torbaya koyar ya da hiçbir somut veriye dayanmaz. Bu yazıda o temelsiz istatistikleri tekrarlamayacağız.
Önünüze konan herhangi bir veriyi 10 dakikada test edebileceğiniz dört adımlı doğrulama yöntemi şöyledir:
- Haber bültenini değil, araştırmanın asıl raporunu bulun. Rakamı, onu üreten ilk kaynağa ulaşana kadar geriye doğru takip edin. İz, bir başka habere atıfta bulunan üçüncü parti bir haberde son buluyorsa, o rakamın aslı astarı yoktur.
- Tam olarak neyin ölçüldüğünü inceleyin. Üretken yapay zekanın her türlü kullanımını kapsayan geniş bir anket, otonom agent mimarilerine dair bir saha çalışması değildir.
- Tarihe ve ölçüm aralığına bakın. Bir yılın belli bir çeyreğinde toplanıp ön rapor olarak yayımlanmış bir oran, sadece o dar zaman diliminin anlık fotoğrafıdır.
- "Başarısızlık" tanımının ne olduğuna bakın. Projenin iptal edilmesi, askıya alınması, çalışmasına rağmen ölçülebilir kâr getirmemesi veya baştan hiç ölçüm yapılmamış olması: bunlar dört ayrı durumdur; ancak piyasa bültenlerinde hepsi tek bir "başarısızlık" rakamı altında toplanır.
Dördüncü adım, bu sansasyonel rakamların çoğunun foyasının ortaya çıktığı yerdir. "Ölçülebilir finansal getiri henüz oluşmadı" demek ile "yapay zeka agent pilotu çöktü" demek aynı şey değildir ve aradaki bu nüans, meselenin asıl özüdür.
Bu süzgeçten başarıyla geçen güvenilir bir kaynağa somut bir örnek verelim: TÜİK'in Yapay Zeka İstatistikleri, 2025 bülteni (Sayı 57945, 1 Ekim 2025), neyi, kimler arasında ve ne zaman ölçtüğünü açıkça ortaya koyar. Bültene göre 2025'te 10-49 çalışanı olan girişimlerin %6,6'sı, 50-249 çalışanı olanların %9,6'sı ve 250 ve üzeri çalışanı olanların %24,1'i herhangi bir yapay zeka teknolojisi kullandığını beyan etmiştir. Dikkat edin: bu veri sadece kullanım oranını ölçer, iş neticesini değil. İkinci sorunun cevabını, yani kaçının kalıcı değere dönüştüğünü aynı nesnel disiplinle yayımlayan bir mecra henüz yoktur.
Kaynağı belirsiz bir istatistik, hiç istatistik olmamasından daha zararlıdır; çünkü başlaması gereken sağlıklı tartışmayı baştan kestirip atar. Bir analist öngörüsü paylaşacaksanız, araştırma şirketinin adını, tarihini ve bunun bir "tahmin" olduğunu aynı cümle içinde net olarak belirtin.
Yalnızca taslak üreten pilotlar, yenmelerine hiç izin verilmeyen bir referansa neden yeniliyor?
Çünkü yapay zeka agent pilotunun işin sadece ufak bir parçacığını yapmasına izin verildi, fakat performans değerlendirmesi yapılırken işin tamamıyla kıyaslandı. Karşılaştırma en başından adil değildi ve oluşan açık haksız şekilde agent'ın yetersizliği olarak kayıtlara geçti.
Bu mantık hatasını tek bir cümleyle özetleyelim: parçalı bir sistemi uçtan uca tam bir sistemle kıyasladınız ve aradaki farkı parçalı sistemin kabahati olarak yazdınız.
Bunun alternatifi pilot bittikten sonra değil, başlamadan önce kararlaştırılır. Agent'ın tek başına tamamlayabileceği aksiyonlar ile insan onayı bekleyecek adımları baştan netleştirin, her iki listeyi de kâğıda dökün ve pilotun başarısını yalnızca belirlenen bu kapsama göre tartın. Taslak üretmekle sınırlandırılmış bir pilot, yalnızca taslak üretme verimliliğiyle raporlanmalı ve personelin harcamaya devam ettiği süre tablodan gizlenmemelidir.
Adil bir karşılaştırma tablosu şöyle kurulur: agent'ın tek başına nihayete erdirdiği vakalardaki uçtan uca süre ve maliyet, personelin aynı tipteki işleri sıfırdan yaparken harcadığı süre ve maliyetle karşılaştırılır. Taslak modunda kalan vakalar ise rapora ayrı bir satır olarak işlenir; orada kazanımın sınırlı kalması bir başarısızlık değil, kapsam kısıtlamasının doğal bir neticesidir.
Gelen kutusu tasnifi ve önceliklendirmesi (triyaj) buna kusursuz bir örnektir. Agent gelen mesajı kategorize edip ilgili birime aktarabiliyor ama nihai yanıtı gönderemiyorsa, ölçtüğünüz şey kategorizasyon başarısıdır; tüm sürecin tamamlanma hızı değil.
Bitirme yetkisi vermeye yönelik en yaygın çekince, agent'ın geri dönüşü olmayan vahim bir hata yapacağı korkusudur. Bu meşru bir tasarım sorusudur; ancak altı ay boyunca körü körüne taslak modunda çakılıp kalmanın bir mazereti olamaz. Hangi adımların insan onayına takılacağı, hangi risk eşiğinde durulacağı ve onayın kimden alınacağı baştan belirlenir ve bu karar pilot başlamadan önce müstakil bir belgede sabitlenir.
Öğleden Sonra Testi: bir süreci finanse etmeden önce sorulacak 10 soru
Öğleden Sonra Testi, tek bir süreç hakkında tek bir öğleden sonrada netleştirebileceğiniz on temel sorudan oluşur; bir yapay zeka agent pilotuna bütçe ayırmadan önce uygulanır. Bu bir puanlama şablonu değildir; doğrudan bir eleme mekanizmasıdır.
Süreci çok dikkatli seçin; doğru aday seçimi başarının yarısıdır. Fiyakalı ve havalı görüneni değil; sıkıcı, yüksek frekanslı ve hatası ucuza telafi edilen süreci seçin. Fiyakalı görünen işler genellikle doğrulama aşamasında çuvallar; çünkü onları fiyakalı kılan şey, sonucun doğruluğunu tartmanın zor ve sübjektif olmasıdır.
Beş ila yirmi kişilik ekiplerde bu profile en uygun üç temel iş vardır: tekrarlayan raporlamalar, sistem mutabakatları ve gelen kutusu tasnifi (triyaj). Üçü de çok sık tekrarlanır, üçünün de çıktısına bakıldığında doğru olup olmadığı anında anlaşılır ve hiçbirinde tek bir münferit hata şirketi batırmaz. Havalı süreçler ise (fiyatlama kararları, şikayet yönetimindeki üslup tercihleri) tam tersidir: seyrek gerçekleşir, doğrulaması zordur ve faturası ağırdır.
İki cazip tuzağın adını baştan koyalım. Birincisi, şirket yöneticisinin sürekli şikayet ettiği kronik süreçtir; bu süreç çoğu zaman tam da belirsiz ve kuralsız olduğu için şikayet konusudur. İkincisi ise sahipsiz süreçtir; ortada sahipsiz kalmasının asıl nedeni kimsenin o sürecin arkasında durmayacak ve onun için yetki sınırlarını esnetmeyecek olmasıdır.
| # | Grup | Soru | Ne "evet" sayılır |
|---|---|---|---|
| 1 | Tanım | Bir çalışan bu süreci uçtan uca tek bir sayfada özetleyebiliyor mu? | Sayfa hazırdır ve bu toplantıdan önce yazılmıştır |
| 2 | Tanım | Her karar noktası kendi şartını ve neticesini açıkça belirtiyor mu? | Hiçbir adım "duruma göre" ile bitmez; inisiyatif gerekiyorsa yetkinin kime ait olduğu sayfada yazılıdır |
| 3 | Girdiler | Agent, personelin kullandığı her girdiyi doğrudan okuyabileceği formatta alıyor mu? | Sistemler ve veri alanları listelenmiştir; alışkanlıkla bakılan ikinci ekranlar dahildir |
| 4 | Girdiler | Girdiler iş başlarken hazır mı, yoksa süreç esnasında mı derleniyor? | Gerçek bir vaka baştan sona işletilmiş, her girdinin nereden ve ne zaman geldiği bizzat görülmüştür |
| 5 | Yetki | Agent'ın tek başına tamamlayabileceği adımların yazılı bir listesi var mı? | Liste temennileri değil, somut aksiyonları tek tek adıyla sayar |
| 6 | Yetki | Bu izinleri verme salahiyetine sahip bir yönetici listeyi resmi olarak onayladı mı? | Rol veya komite değil; unvanı ve adı belli gerçek bir kişi |
| 7 | Doğrulama | Hatalı bir çıktı, üretilme süresinden daha hızlı fark edilip yakalanabiliyor mu? | Kontrol adımı ve süresi bellidir; kontrol etmek işi yapmaktan uzun sürüyorsa yanıt hayırdır |
| 8 | Doğrulama | Hatalı bir işlem geri alınabiliyor mu; kim tarafından ve ne kadar sürede? | Yetki listesindeki her aksiyonun ya net bir geri alma yolu ya da önünde onay kapısı vardır |
| 9 | Hacim | Süreç, istisnaları bir haftada gösterecek kadar yüksek frekansta çalışıyor mu? | Tahminler değil, sistem loglarından çekilmiş gerçek haftalık vaka adedi |
| 10 | Sahiplik | Bu sürecin sorumluluğunu bugün fiilen üstlenen adı belli tek bir sahip var mı? | Adını tereddütsüz söyleyebiliyorsunuz ve o kişi de bu sorumluluğun bilincinde |
Puanlama kuralı basit bir aritmetik değildir. Tanım veya yetki grubundaki tek bir "hayır", puan düşürme sebebi değil, doğrudan süreci durdurma gerekçesidir. Birinci veya altıncı soruda takılan bir süreç "biraz eksik puanlı" bir aday değil, kesinlikle yanlış bir adaydır; diğer soruların tamamına verilen "evet" yanıtları bu gerçeği değiştiremez.
Bu test sadece bir öğleden sonra sürer; çünkü hazırlık değil, doğru üç kişinin varlığını gerektirir: işi bugün fiilen yürüten kişi, süreç çıktısından sorumlu olan yönetici ve sistem yetkilerini onaylama salahiyetine sahip yetkili. Bu üç kişiyi iki saatliğine aynı masaya oturtamıyorsanız, zaten onuncu sorunun cevabını daha başlamadan almışsınız demektir.
Öğleden Sonra Testi bir sürecin otomasyona uygun olup olmadığını ortaya koyar, adayları kendi içinde yarıştırmaz; sıralama yapmak ise çıktının ne kadar hızlı doğrulandığına ve olası hatanın ne kadar ucuza telafi edildiğine bakan ayrı bir değerlendirmedir.
Bir süreci doğrudan eleyen nedir? Beş durdurma koşulu
Öğleden Sonra Testi'nin diğer maddeleri ne sonuç verirse versin, şu beş koşuldan biri bile varsa o yapay zeka agent pilotunu hiç başlatmamak gerekir. Bunlar kırmızı çizgidir ve her biri tek başına projeyi çökertebilir:
- Kimse süreci kâğıda dökemiyor. "Biraz zaman alır, bakarız" durumu değil; ortada o tek sayfayı çıkarabilecek kimse yoktur.
- Çıktı, üretilme hızından daha süratli kontrol edilemiyor. Bir kalemi doğrulamak onu yapmaktan daha pahalıya patlıyorsa, hacim arttığı anda sistem gözden geçirme kuyruğunda boğulur.
- Hatalı bir işlem ne geri alınabiliyor ne de önceden onay kapısına bağlanabiliyor. Aksiyonun geri dönüşü yoksa ve insan onayını korumaya yanaşmıyorsanız, bu süreç agent için uygun değildir.
- Sürecin temas ettiği sistemlerin canlı ortamda çalıştığı kanıtlanmamış. Dokümantasyonda yazması yetmez. Gerçek bir kişinin canlı sisteme karşı başarılı bir çağrı yürüttüğü ve sonucunu bizzat gösterdiği doğrulanmalıdır.
- Agent'ın yetki sınırlarını genişletebilecek adı belli bir süreç sahibi yok. O sahip masada yoksa pilot başarılı çıksa bile rafta kalır; çünkü kimse demoyu resmi izne dönüştürme cesaretini gösteremez. O kişi agent'ın yazılı görev tanımında açıkça yer almalıdır.
Katı eleme kuralının ağırlıklı puanlamadan üstün olmasının çok basit bir nedeni vardır: ağırlıklı puan, ölümcül tek bir kusuru diğer dört rahat maddenin yüksek ortalamasında gizler. Doğrulanamayan ama diğer kriterlerde tam not alan bir süreç kağıt üzerinde parlak bir aday gibi çıkar; oysa gerçekte tam bir fiyaskodur.
Dördüncü koşul, sektörde herkesin boş verip üstünden atladığı maddedir. Tedarikçilerin sunduğu entegrasyon listelerine kesin kanıt değil, birer iddia gözüyle bakın; buna bizim platformumuz da dahildir. Kendi yetenek kataloğumuzu titizlikle denetlediğimizde, listelenen bazı kayıtların arkasında çalışan canlı bir servis bulunmadığını ve keşif aracımızın bunları hâlâ agent'lara önerdiğini fark ettik. Canlı bir endpoint'i olmayan her şeyi gizleyen sıkı bir kontrol mekanizması getirdik. Bir pilota kaynak ayırmadan önce, entegre olunacak her sisteme karşı ekibinizden birine gerçek bir çağrı yaptırın ve dönen başarılı sonucu kendi gözlerinizle görün.
Kişisel verilere temas eden süreçler için ek koşul. Süreç kişisel veri işliyorsa, teknik hazırlıktan önce yetki ve onay çerçevesini çizmeniz şarttır: hangi veriye kim, hangi meşru gerekçeyle erişiyor ve hatalı bir işlemde hukuki sorumluluk kime ait? Bu sadece teknik bir mesele değil, yetki mimarisi ve denetim izi (audit trail) tasarımı meselesidir; detayları onay kapıları rehberimizde bulabilirsiniz.
Bu çekince Türkiye iş dünyasında somut karşılığı olan bir gerçektir. TÜİK'in 2025 bülteninde, yapay zeka kullanmayan ancak planlayan işletmelerin tereddüt nedenleri arasında %74,2 ile uzmanlık eksikliği, %67,4 ile yüksek maliyetler ve %62,4 ile olası bir zarar durumunda hukuki sorumluluğun kime ait olacağına dair belirsizlik yer almıştır. Hukuki sorumluluk sorusu, teknik engellerin hemen yanı başında durmaktadır.
Yapay zeka agent pilotunu, çıkan rakam bir şey ifade edecek şekilde nasıl ölçersiniz?
Nihayete ermiş sonuçları, kuyruk uzunluğunu ve işlem başına birim maliyeti ölçün. Örnek vakalardaki soyut "model doğruluğu", ölçülmesi en zahmetsiz ama rapora yazıldığında en anlamsız sayıdır; çünkü işin hiçbir zaman asıl darboğazını temsil etmez.
Dört temel ölçüm kriteri:
- El değmeden tamamlanma oranı (Straight-through processing). Agent'ın insan müdahalesi olmadan baştan sona başarıyla bitirdiği vakaların toplam içindeki payı.
- Tepe gözden geçirme kuyruğu uzunluğu. Bir personelin onayını bekleyen maksimum birikim; sıradan günlerde değil, işin tavan yaptığı en yoğun saatlerde ölçülür.
- Hatalı bir çıktının toplam maliyeti. Hatalı bir sonucun düzeltilmesi, telafisi ve operasyonel etkileri dahil şirkete getirdiği gerçek fatura.
- Tamamlanmış sonuç başına birim maliyet. Toplam maliyetin, havada kalan denemelere değil, başarıyla noktalanan nihai iş adedine bölünmesi.
Bu dört metriğin ikisi bugün muhtemelen şirketinizde hiç takip edilmiyor. Kuyruk uzunluğunu ölçmek için pahalı yazılımlara ihtiyacınız yok: bir hafta boyunca günün en yoğun anında masada veya ekranda onay bekleyen işleri elle saymak bile yeterlidir.
Referans ölçümünü yapay zeka agent pilotu başlamadan önce ve aynı operasyonel hacimde yapın. Süreç bittikten sonra geriye dönük kurgulanan bir referans ölçüm değil, sadece sübjektif bir savunmadır ve nereye çekeceğini herkes tahmin eder.
Dördüncü metrik hakkında küçük bir not: platformumuzda tekrarlayan işlerin toplu bir hesap ekstresi yerine işlem başına maliyet sayacı taşımasının nedeni budur. Bir pilotun tamamlanmış birim sonuç başına maliyete ihtiyacı vardır; genel gider toplamları böyle bir netlik sağlayamaz.
"Süreç patlamadı / hata vermeden bitti" demek bir başarı metriği değildir.
Nitelikli bir pilot raporu kısa ve nettir: Dört rakam, bir önceki durum, bir sonraki durum ve her ikisinin de test edildiği gerçek hacim.
Üretime geçen yapay zeka agent pilotları neyi farklı yaptı?
Süreci daralttılar, yetkiyi genişlettiler ve tek bir net sahip belirlediler. Bunlar teorik temenniler değil, sahada gözlemlenebilen somut davranışlardır.
Daraltmak; vaka çeşitlerini yarıya indirip en sık gelen iki ana kaleme odaklanmak demektir. Genişletmek; agent'ın tek başına tamamlayabileceği aksiyonların yazılı bir listesini çıkarıp bunu yetkili yöneticiye imzalatmak demektir. Sahip belirlemek ise; adı kapsam dokümanında açıkça yazan ve gerektiğinde ekibi toplamaya gerek duymaksızın inisiyatif alıp kapsamı güncelleyebilen bir lider demektir.
Buradaki daralma, işi küçültmek değil, vaka çeşitliliğini sadeleştirmek anlamına gelir. Yirmi farklı talep tipiyle yola çıkan bir pilot, yirmi ayrı tanım belirsizliğini sırtında taşır. En sık gelen iki taleple başlayan pilot ise sadece iki tanım problemiyle uğraşır ve ikisi de tek bir öğleden sonrada çözüme kavuşur. Yetki genişletmesi de bir gecede olmadı: önce hatası en ucuz olan rutin aksiyonlar açıldı, loglar bir hafta dikkatle izlendi, ardından bir sonraki aksiyona izin verildi.
Dördüncü ve en kritik fark ise şudur: Başarılı ekipler yapay zeka agent pilotunu cımbızla seçilmiş steril vakalarda değil, sistemi zorlayan gerçek operasyon hacminde koşturdular ve bunu arızaların henüz tolere edilebildiği erken aşamada yaptılar. Yalnızca tertemiz örnekler görmüş bir pilot gerçekte test edilmiş sayılmaz; sadece tatbikat yapmıştır, henüz ateş hattına girmemiştir.
Eğri oturup doğru konuşalım, bunu dipnota saklamadan açıkça söyleyelim: Bu tespitler, yüzlerce müşteri deneyiminden ve kendi canlı sistemlerimizi işletirken bizzat edindiğimiz tecrübelerden süzülen pratik bir tablodur; laboratuvar ortamında yapılmış yapay bir deney değildir. Bunu mutlak bir kural gibi değil, kendi operasyonunuzda sınayacağınız somut bir hipotez olarak ele alın.
Yapay zeka agent pilotunuz zaten durduysa ne yapmalısınız?
Hiçbir şeyi alelacele değiştirmeden önce üç arıza modundan hangisinde sıkışıp kaldığınızı teşhis edin; çünkü bu üç çözüm aynı bütçenin birbirini dışlayan farklı kulvarlarıdır. Sorun süreç belirsizliğiyken teknoloji veya araç değiştirmek, size sadece duvara toslayan ikinci bir pilot kazandırır.
Karar basamaklarını sırayla takip edin:
- Süreç yazılı ve net mi? Değilse hemen durun ve süreci yazın. Tanımsız süreç açmazındasınız ve bunu hiçbir teknolojik platform çözemez.
- Yazılıysa, agent'ın tek başına nihayete erdirmesine izin verilen somut bir adım var mıydı? Yoksa asıl çözüm buradadır ve bu bir teknoloji meselesi değil, yetkilendirme kararıdır. Son mil açmazındasınız.
- Yetki verildiyse, insan gözden geçirme kuyruğu akıcı şekilde işledi mi? Hacim arttıkça birikim ve tıkanma büyüdüyse odaklanmanız gereken yer burasıdır. Gözden geçirme kuyruğuna takıldınız; çözüm daha hızlı okuyan bir insan bulmak değil, risk kademelendirmesi ve akıllı örnekleme yapmaktır.
Bu üç soruyu tek bir değerlendirme toplantısında netleştirebilirsiniz ve çıkacak yanıtlar genelde masadaki kimse için şaşırtıcı olmaz. Asıl şaşırtıcı olan, üç çözümün de aynı bütçe havuzundan pay istemesidir. İkisine aynı anda kaynak ayırmaya kalkışmak, genellikle ikisini de yarım bırakmanın en garanti yoludur.
Dördüncü bir yol daha vardır ve bazen en rasyonel tercih odur: Projeyi durdurmak. Süreç yukarıda saydığımız beş durdurma koşulundan birine takılıyorsa, projeyi rafa kaldırmak en doğru karardır ve harcamanın henüz bu aşamasındayken şirkete ciddi tasarruf sağlar. Bu kararın en pahalı ve yıpratıcı olanı ise, ikinci yapay zeka agent pilotu da hüsranla bittikten sonra mecburen verilendir.
Son noktayı açık yüreklilikle koyalım: Net bir eleme üreten bir yapay zeka agent pilotu, kesinlikle başarıyla sonuçlanmış bir çalışmadır. Size hangi sürece yatırım yapmamanız gerektiğini göstermiştir; bu da hangi sürece yatırım yapacağınızı bilmek kadar değerli bir içgörüdür.
Masanızdaki süreç için tanım ve yetki sorularına tatmin edici yanıtlar veremiyorsanız, kararınız nettir ve bu, sürecin üretebileceği en ucuz kazançtır. Süreci netleştirin, agent'ın neyi tek başına bitireceğini kararlaştırın ve Öğleden Sonra Testi'ni önümüzdeki hafta yeniden uygulayın.
Münferit bir süreç yerine tüm kurumsal operasyonunuzun yapay zeka olgunluğunu ölçmek isterseniz, AIQ değerlendirmesi ile hazırlık skorunuzu, operasyonel arketipinizi ve boyut kırılımlarınızı anında analiz edebilirsiniz.
Sık sorulan sorular
Karar vermeden önce bir yapay zeka agent pilotu ne kadar sürmeli?
Takvimdeki sabit bir hafta sayısı kadar değil, sistemi zorlayan gerçek operasyon hacmine ulaşana kadar. Yapay zeka agent pilotunu işin tam bir döngüsünden geçirin: sezonluk yoğunluklar ve çalışanların normalde etrafından dolaştığı pürüzlü vakalar dahil. Sadece özenle seçilmiş steril örnekleri görmüş bir pilot size gerçek durumu göstermez.
Şirket içinde bir yapay zeka agent pilotunun sahibi kim olmalı?
Süreci bugün fiilen sahiplenen, unvanı ve adı belli tek bir yönetici; komite değil, harici tedarikçi değil. Yetki sınırlarını o çizer, agent'ın tek başına neyi bitireceğini o onaylar ve nihai neticenin hesabını şirkete o verir. Tek bir sorumlu lideri olmayan projeler sessizce rafa kalkar; çünkü hiç kimse agent'ın sistem yetkilerini genişletme sorumluluğunu tek başına üstlenmez.
Bu süreç için agent mı, kural tabanlı iş akışı otomasyonu mu kullanmalıyım?
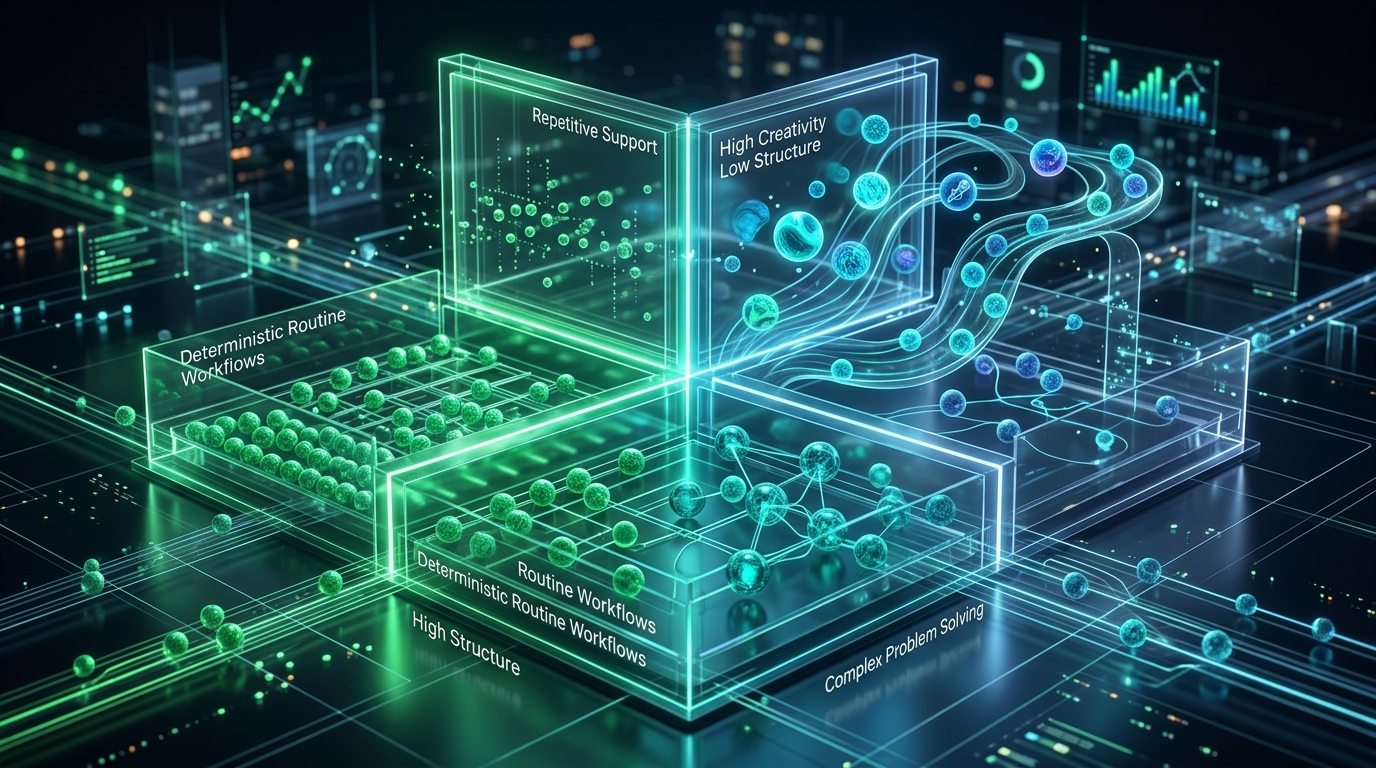
Kendinize tek bir soru sorun: Süreçteki adımlardan herhangi biri yapılandırılmamış serbest metinleri okumayı veya belirsiz bir durumu inisiyatif kullanarak yorumlamayı gerektiriyor mu? Gerektirmiyorsa kural tabanlı iş akışı otomasyonu çok daha ucuz, hızlı ve öngörülebilirdir. Gerektiriyorsa o yorum adımı agent'ın, geri kalan deterministik adımlar ise kuralların işidir. Gerçek iş süreçlerinin çoğu birini değil, her ikisinin hibrit uyumunu gerektirir.
Üretim sistemlerine bağlamadan bir yapay zeka agent pilotu koşturabilir miyiz?
Koşturabilirsiniz, ancak elde edeceğiniz sonuç sahaya taşınamaz. Dışa aktarılmış statik veriler üzerinde çalışan bir pilot, agent'ın süreç üzerinde akıl yürütebildiğini gösterir; işi canlıda fiilen bitirebildiğini değil. Yaygınlaştırmayı asıl durduran arızalar canlı entegrasyonlarda gizlidir: API izinleri, rate limit sınırları, zaman aşımı ve bayatlamış veriler. Pilota başlamadan önce, entegre olunacak her sisteme karşı canlı ortamda gerçek bir çağrının başarıyla çalıştığını kanıtlayın.
Yapay zeka agent pilotumuz başarılı oldu ama kimse yaygınlaştırmayı onaylamıyor. Neden?
Genellikle pilot sadece teknik yeteneği kanıtladığı, yaygınlaştırma ise kurumsal yetki gerektirdiği ve karar anında masada bu yetkiyi verebilecek bir yönetici bulunmadığı için. Agent'ın operasyonel izinlerini genişletebilecek karar vericiyi bulun ve masasına tam olarak ihtiyacı olan şeyi koyun: agent'ın tek başına kapatacağı aksiyonların net listesi ve olası bir hata durumunda devreye girecek telafi mekanizması.